OCR et IA : automatiser la saisie de vos documents
Une fiche papier arrive, puis quelqu'un recopie son contenu dans un logiciel. L'OCR peut préparer cette saisie, à condition de prévoir ce qui se passe après la lecture.

Louis Schinkler
Expert IA & Automatisation
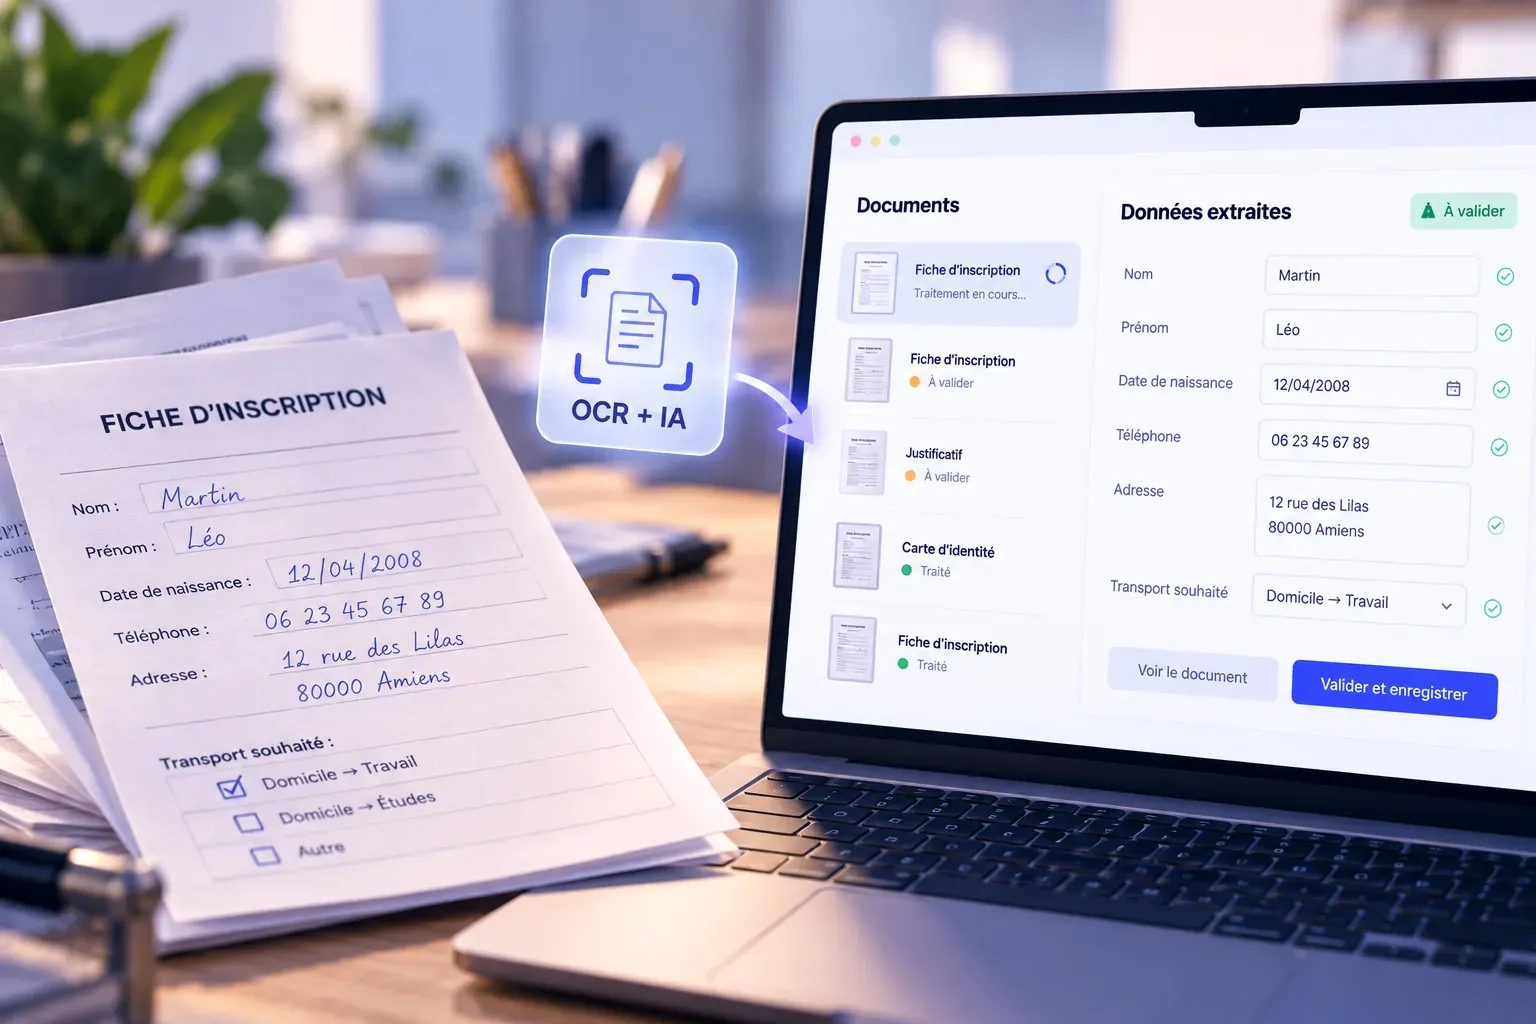
Pour automatiser la saisie de documents, l’OCR reconnaît le texte d’un scan ou d’une photo. Un traitement d’extraction répartit ensuite les informations dans les champs attendus par votre logiciel. L’IA peut aider à lire des documents dont la présentation varie. Il reste à vérifier les valeurs et à organiser leur enregistrement.
Un nom bien lu peut encore se retrouver dans le mauvais dossier. Il faut donc prévoir comment rattacher la fiche à une personne connue du logiciel et comment réagir si cette fiche a déjà été envoyée. C’est à cet endroit que se joue une partie du temps gagné sur la saisie.
Du texte lu aux données utilisables
Sur une fiche d’inscription, plusieurs dates peuvent apparaître. Votre logiciel attend peut-être la date de naissance dans un champ et celle de la demande dans un autre. Le traitement doit les distinguer, puis les transmettre dans le format prévu.
La documentation OCR de Mistral décrit la lecture de PDF et d’images, avec restitution de leur contenu. Les annotations documentaires permettent de demander une extraction selon une structure définie. Cela sert par exemple à récupérer les rubriques d’un formulaire sous forme de données que votre application peut exploiter.
Un format correct ne garantit toutefois pas que la valeur lue soit exacte. Un numéro peut contenir le bon nombre de chiffres et correspondre à une mauvaise lecture. Les contrôles doivent porter sur ce qui compte pour votre activité, avec une relecture lorsqu’une erreur aurait des conséquences difficiles à corriger.
Choisissez une famille de documents pour le premier essai
Commencez par un document fréquent dont vous connaissez bien le traitement. Une fiche d’adhésion utilisée chaque semaine donne un point de départ plus facile à évaluer qu’un dossier composé de pièces très différentes.
Préparez un échantillon qui ressemble aux documents reçus au quotidien. Ajoutez des photos mal cadrées et des champs laissés vides. Si vous recevez des corrections manuscrites, il faut les inclure aussi. Un essai limité à des scans parfaitement lisibles renseigne peu sur le travail qui restera à l’équipe.
Pour chaque document, faites relever les valeurs attendues par une personne qui connaît le dossier. Cette référence permettra de comparer le résultat de l’outil. Gardez une partie des documents pour un second essai, après les réglages, afin de vérifier le comportement sur des fichiers qui n’ont pas servi à les ajuster.
Prévoyez ce qui se passe quand une donnée pose problème
La première version devrait proposer une vérification avant l’enregistrement définitif. Afficher le document à côté des champs extraits permet de corriger une lecture sans changer d’écran.
Quelques cas méritent une décision explicite dès le départ :
| Cas rencontré | Comportement à prévoir |
|---|---|
| Un champ obligatoire est vide | Mettre le dossier en attente et indiquer l’information manquante |
| Une référence ne correspond à aucune donnée connue | Demander une vérification avant de créer une nouvelle entrée |
| Le même document est déposé une seconde fois | Signaler un doublon possible et permettre de le contrôler |
| Le logiciel destinataire refuse l’enregistrement | Conserver le travail validé et afficher l’erreur pour permettre une reprise |
Si une réponse tarde après l’envoi, vérifiez si le logiciel a déjà enregistré le dossier avant de renvoyer la demande. Sinon, une simple nouvelle tentative peut créer un doublon. Testez ce cas pendant la mise au point de l’intégration, même si la lecture du document est parfaite.
Gardez une trace des corrections et du document d’origine selon les règles de conservation définies pour votre activité. Lorsque vous ajustez le traitement, ces exemples aident à comprendre les erreurs qui reviennent. Une correction manuelle n’améliore pas automatiquement le modèle : il faut prévoir comment elle sera réutilisée.
Bus Citoyens : conserver le papier côté usager
Bus Citoyens propose du covoiturage à moindre coût dans les Hauts-de-France. L’association conserve des fiches papier pour les personnes éloignées du numérique. Les informations de ces fiches doivent ensuite rejoindre l’application.
Nous avons développé une interface qui reçoit les documents numérisés et s’appuie sur Mistral pour en lire le contenu. Les données extraites sont transmises à l’application par son API. Le projet porte donc sur le passage du papier au logiciel, tout en maintenant le mode d’inscription utilisé par les usagers.
La réalisation OCR Bus Citoyens présente l’interface et le fonctionnement livré. Ce cas peut intéresser une association qui garde ses inscriptions papier, mais aussi une entreprise qui reçoit encore des formulaires remplis à la main. Il faut ensuite tester les documents propres à chaque structure : la qualité obtenue sur une fiche ne permet pas de prédire celle d’une autre.
Tous les documents ne demandent pas de l’OCR
Avant de faire lire une image, regardez comment le document a été produit. Si votre partenaire peut fournir un export structuré avec les mêmes informations, cet export peut éviter une étape de reconnaissance. Un PDF qui contient déjà du texte exploitable peut également se traiter sans OCR, même si les tableaux demandent parfois un travail d’extraction.
Chez FC Artifices, nous avons construit des traitements par règles pour rapprocher les produits des plans de tir avec le stock existant. Le projet n’utilise ni OCR ni IA générative. Notre étude de cas sur les plans de tir explique ce choix. L’origine des documents et les règles de correspondance guidaient la solution.
Le même raisonnement s’applique à la sortie. Si votre application possède déjà les données, elle peut générer directement les PDF à envoyer. Cela évite de remettre en page à la main des informations qui sont déjà enregistrées.
Mesurez le traitement complet d’une fiche
Chronométrez le travail depuis la réception du document jusqu’au moment où votre équipe peut utiliser ses données dans le logiciel. Dans le parcours automatisé, comptez le temps de préparation de l’image et celui consacré aux vérifications. Le temps de réponse du modèle ne couvre qu’une partie de ce travail.
Par exemple, imaginons un lot de 50 fiches qui demande quatre minutes de saisie par fiche. Cela représente 200 minutes. Si le nouveau parcours demande une minute et demie par fiche, préparation et corrections comprises, le lot prend 75 minutes. L’écart est de 125 minutes pour ce lot fictif. Refaire ce calcul sur vos documents permettra de voir si le gain se maintient quand la qualité des scans baisse.
Suivez aussi les erreurs qui passent malgré les contrôles. Le temps gagné sera difficile à défendre si quelqu’un doit ensuite rechercher des dossiers mal enregistrés. Les résultats du premier essai vous aideront à décider quels champs peuvent être acceptés automatiquement et lesquels doivent encore être relus.
Pour préparer cet essai, commencez par décrire le trajet d’une fiche et les champs à récupérer. Notre page sur les projets d’IA pour les entreprises présente notre manière de cadrer les documents accessibles et les connexions nécessaires. Nous intervenons à Amiens et dans les Hauts-de-France, ainsi qu’à distance selon le projet.
Questions fréquentes
✦Quelle est la différence entre OCR et extraction de données ?
L'OCR reconnaît le texte présent dans une image ou un document numérisé. L'extraction associe ensuite les informations aux champs attendus, par exemple un nom dans la fiche client. Certains outils combinent ces fonctions, mais les données obtenues doivent encore être contrôlées avant leur enregistrement.
✦L'OCR peut-il lire des fiches manuscrites ?
Certains modèles prennent en charge des documents manuscrits. Le résultat dépend de l'écriture et de la qualité de l'image. Testez des fiches représentatives de votre activité, y compris celles que votre équipe trouve difficiles à lire, avant de fixer le niveau de validation nécessaire.
✦Peut-on envoyer les données directement dans notre logiciel ?
Cela dépend des possibilités de votre logiciel. Une API ou un import documenté peuvent permettre l'intégration. Il faut vérifier les champs attendus et prévoir les doublons ainsi que les échecs d'enregistrement. La lecture du document peut fonctionner alors que le logiciel destinataire refuse les données.
✦Comment savoir si l'automatisation fait gagner du temps ?
Comparez le temps total consacré aux mêmes documents avant et après l'automatisation. Incluez la préparation des scans et les corrections, jusqu'à l'enregistrement réussi dans le logiciel. Notez séparément les erreurs restantes pour éviter qu'un traitement plus rapide masque une perte de qualité.
Sources & références
À lire aussi
Automatisation : comment calculer sa rentabilité ?
Gagner cinq minutes sur un dossier ne suffit pas à chiffrer un projet. Il faut compter les vérifications restantes, les exceptions et les frais qui reviennent chaque mois.
Chatbot sur vos documents : par où commencer ?
Votre équipe pose souvent les mêmes questions sur les procédures. Un chatbot documentaire peut aider, mais il faut commencer par choisir les documents qui font foi.
Remplacer Excel par une application : quand le faire ?
Votre équipe travaille dans un tableur qui demande de plus en plus d'attention. Le bon choix dépend de ce qui vous coûte du temps autour du fichier.
Vous recopiez régulièrement les mêmes documents ?
Dites-nous quel document vous recevez et dans quel logiciel ses informations doivent arriver. Nous pourrons définir un premier essai sur ce parcours.
Parler de mes documents